C 运算符优先级
https://cppreference.cn/w/c/language/operator_precedence
printf 函数
prinf 格式化打印
| 格式控制符 | 说明 |
|---|---|
| %c | 输出一个单一的字符 |
| %hd、%d、%ld | 以十进制、有符号的形式输出 short、int、long 类型的整数 |
| %hu、%u、%lu | 以十进制、无符号的形式输出 short、int、long 类型的整数 |
| %ho、%o、%lo | 以八进制、不带前缀、无符号的形式输出 short、int、long 类型的整数 |
| %#ho、%#o、%#lo | 以八进制、带前缀、无符号的形式输出 short、int、long 类型的整数 |
| %hx、%x、%lx %hX、%X、%lX | 以十六进制、不带前缀、无符号的形式输出 short、int、long 类型的整数。如果 x 小写,那么输出的十六进制数字也小写;如果 X 大写,那么输出的十六进制数字也大写。 |
| %#hx、%#x、%#lx %#hX、%#X、%#lX | 以十六进制、带前缀、无符号的形式输出 short、int、long 类型的整数。如果 x 小写,那么输出的十六进制数字和前缀都小写;如果 X 大写,那么输出的十六进制数字和前缀都大写。 |
| %f、%lf | 以十进制的形式输出 float、double 类型的小数 |
| %e、%le %E、%lE | 以指数的形式输出 float、double 类型的小数。如果 e 小写,那么输出结果中的 e 也小写;如果 E 大写,那么输出结果中的 E 也大写。 |
| %g、%lg %G、%lG | 以十进制和指数中较短的形式输出 float、double 类型的小数,并且小数部分的最后不会添加多余的 0。如果 g 小写,那么当以指数形式输出时 e 也小写;如果 G 大写,那么当以指数形式输出时 E 也大写。 |
| %s | 输出一个字符串 |
int main() {
    unsigned char c = -65;   //数据类型前面添加unsigned关键字表示采用无符号形式
    printf("%u", c);    //%u以无符号形式输出十进制数据
}
常量
在 C 中,有两种简单的定义常量的方式:
- 使用 define 预处理器: define 可以在程序中定义一个常量,它在编译时会被替换为其对应的值。
- 使用 const 关键字:const 关键字用于声明一个只读变量,即该变量的值不能在程序运行时修改。
#define PI 3.14159在程序中使用该常量时,编译器会将所有的 PI 替换为 3.14159。
#include <stdio.h>

#define LENGTH 10
#define WIDTH  5
#define NEWLINE '\n'

int main()
{

   int area;

   area = LENGTH * WIDTH;
   printf("value of area : %d", area);
   printf("%c", NEWLINE); // 等价于 printf("\n");

   // value of area : 50

   return 0;
}
#include <stdio.h>
int main()
{
const int LENGTH = 10;
const int WIDTH = 5;
const char NEWLINE = '\n';
int area;
area = LENGTH * WIDTH;
printf("value of area : %d", area);
printf("%c", NEWLINE);
return 0;
}请注意,把常量定义为大写字母形式,是一个很好的编程习惯。
define 与 const 区别
define 与 const 这两种方式都可以用来定义常量,选择哪种方式取决于具体的需求和编程习惯。通常情况下,建议使用 const 关键字来定义常量,因为它具有类型检查和作用域的优势,而 define 仅进行简单的文本替换,可能会导致一些意外的问题。
define 预处理指令和 const 关键字在定义常量时有一些区别:
-
替换机制:
#define是进行简单的文本替换,而const是声明一个具有类型的常量。#define定义的常量在编译时会被直接替换为其对应的值,而const定义的常量在程序运行时会分配内存,并且具有类型信息。 -
类型检查:
#define不进行类型检查,因为它只是进行简单的文本替换。而const定义的常量具有类型信息,编译器可以对其进行类型检查。这可以帮助捕获一些潜在的类型错误。 -
作用域:
#define定义的常量没有作用域限制,它在定义之后的整个代码中都有效。而const定义的常量具有块级作用域,只在其定义所在的作用域内有效。 -
调试和符号表:使用
#define定义的常量在符号表中不会有相应的条目,因为它只是进行文本替换。而使用const定义的常量会在符号表中有相应的条目,有助于调试和可读性。
#include <stdio.h>

#define PI 3.14159     // 宏定义常量
const double pi = 3.14159; // const 常量

int main() {
    int r = 2;

    // 使用 #define
    double area1 = PI * r * r;  // PI 在编译时直接被替换成 3.14159
    printf("area1 = %f\n", area1);

    // 使用 const
    double area2 = pi * r * r;  // pi 有类型,编译器会检查类型是否匹配
    printf("area2 = %f\n", area2);

    return 0;
}
#include <stdio.h>
#define VALUE 100 // 全局宏,定义后整个文件有效
int main() {
const int localValue = 200; // const 常量,作用域仅限 main 函数
printf("%d\n", VALUE); // 可以用
printf("%d\n", localValue); // 可以用
}
// 在这里还能继续用 VALUE
// printf("%d\n", localValue); // ❌ 错误,localValue 作用域仅在 main函数
#include <stdio.h>

void test(void);   //定义函数原型,因为C语言是从上往下的,所以如果要在下面的主函数中使用这个函数,一定要定义到它的上面。

int main() {

}

void test(void){   //函数具体定义,添加一个花括号并在其中编写程序代码,就和我们之前在main中编写一样
    printf("我是测试函数!");
}
或是直接在上方写上函数的具体定义:
#include <stdio.h>

void test(void){   //函数具体定义,添加一个花括号并在其中编写程序代码,就和我们之前在main中编写一样
    printf("我是测试函数!");
}

int main() {

}
函数参数和返回
#include <stdio.h>

void swap(int, int);

int main() {
    int a = 10, b = 20;
    swap(a, b);

    printf("a = %d, b = %d", a, b);   //最后会得到什么结果?
    // a 和 b 不会进行交换
}

void swap(int a, int b){
    int tmp = a;   //这里对a和b的值进行交换
    a = b;
    b = tmp;
}修改形式参数的值,外面的实参值会跟着发生修改吗?不会。
函数的形参实际上就是函数内的局部变量,它的作用域仅仅是这个函数,而我们外面传入的实参,仅仅只是将值赋值给了函数内的形参而已,并且外部的变量跟函数内部的变量作用域都不同,所以半毛钱关系都没有,这里交换的仅仅是函数内部的两个形参变量值,跟外部作实参的变量没有任何关系。
那么,怎么样才能实现通过函数交换两个变量的值呢?这个问题我们会在指针部分进行讨论。
再来看一个例子:
#include <stdio.h>

void increaseA(int a){
    a += 10;
    printf("%d\n", a);
}

int main() {
    int a = 10;
    increaseA(a); //每次执行完test()就自动销毁
    increaseA(a);   //连续两次调用,那么这两次的结果会是什么?
    // 20
    // 20
}
注意每次调用函数都是单独进行的,并不是复用函数中的形参,不要认为第一次调用函数test就将函数的局部变量变成20了,再次调用就是20+10变成30。实际上这两次调用都是单独进行的,形参a都是在一开始的时候被赋值为实参的值的,这两次调用没有任何关系,并且函数执行完毕后就自动销毁了。
指针
程序中使用的变量实际上都在内存中创建的,每个变量都会被保存在内存的某一个位置上(具体在哪个位置是由系统分配的),就像我们最终会在这个世界上的某个角落安家一样,所有的变量在对应的内存位置上都有一个地址(地址是独一无二的),而我们可以通过这个地址寻找到这个变量本体,比如int占据4字节,因此int类型变量的地址就是这4个字节的起始地址,后面32个bit位全部都是用于存放此变量的值的。
假设此为32 位系统,32位处理器,指的是CPU内部的通用寄存器的宽度为32位,一次能处理的最大位数为32位(一次处理4个字节),它的地址总线位数为32位 (地址总线位数决定了CPU的寻址能力)。
可寻址物理地址范围为4GB() 。4GB即4G个字节,CPU可寻址4G个地址,根据内存地址访问内存的存储单元。
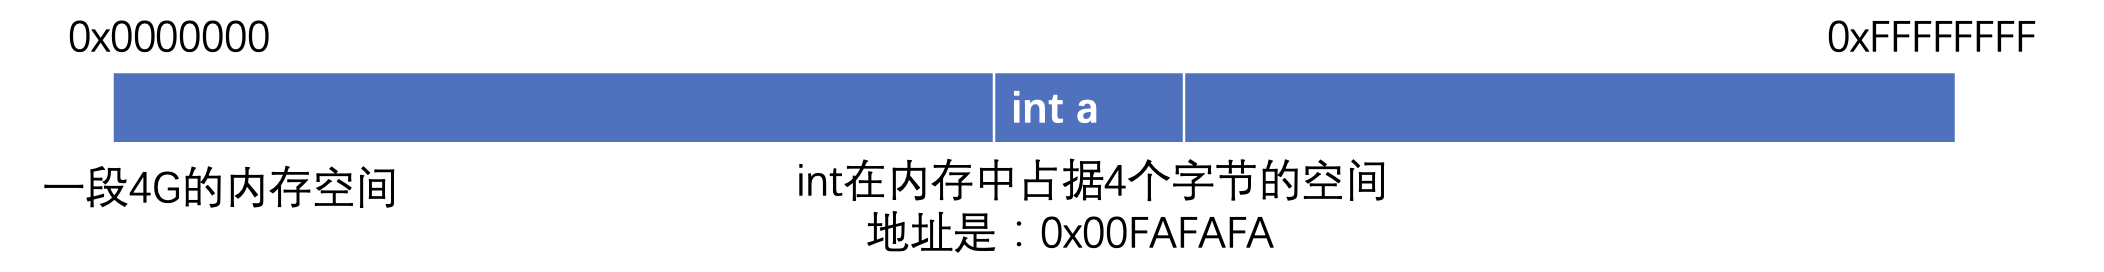
这里的0x是十六进制的表示形式(10-15用字母A - F表示)如果我们能够知道变量的内存地址,那么无论身在何处,都可以通过地址找到这个变量了。而指针的作用,就是专门用来保存这个内存地址的。
内存地址由计算机操作系统分配,每一个字节分配一个内存地址,cpu只需要知道某个数据类型的地址, 就可以直接去到读影的内存位置去提取数据(这里的”直接”,指直接寻址技术)。
由此可知,32位的操作系统(32位处理器或64位处理器的计算机才能装32位操作系统),即使配上8GB内存,操作系统最多也只能给其中4GB分配地址。(实际能被操作系统访问到的一般是3.2GB左右,有一部分会被显卡缓存等占用)
CPU发展迅猛,从零几年开始CPU就全都是64位的了,64位CPU理论上最多支持16EB内存,可理解成近似于无限大。
比如0x00FAFAFA为这个变量的起始地址
- 第 1 个字节:
0x00FAFAFA - 第 2 个字节:
0x00FAFAFB - 第 3 个字节:
0x00FAFAFC - 第 4 个字节:
0x00FAFAFD
所以它的末尾地址 = 0x00FAFAFD
举个例子:
| 地址 | 存放的值 |
|---|---|
| 11000 | 10000 |
| 11001 | 10000 |
| … | |
| … | |
| 11004 | 10005 |
| 10000 | ’f’ |
| … | |
| 10005 | 123 |
| … |
指针就是内存中的地址,指针变量就是用来存放地址的变量.
char *pa; // 定义一个指向字符型的指针变量
int *pb; // 定义一个指向整形的指针变量如果需要获取某个变量的地址,可以使用地址运算符
&
如果需要访问指针变量指向的数据,可以使用取值运算符*
#include <stdio.h>
int main()
{
    char a = 'A';
    int f = 123;

    char *pa = &a;
    int *pb = &f;

    printf("a = %c\n", *pa); // 用 * 取值
    printf("f = %d\n", *pb);

    //通过指针简介访问变量
    *pa = 'B';
    *pb = 456;

    printf("now, a = %c\n", *pa);
    printf("now, f = %d\n", *pb);

    printf("the address of pa = %p\n", pa);
    printf("the address of pb = %p\n", pb);

    return 0;
}
a = A
f = 123
now, a = B
now, f = 456
the address of pa = 00000000005FFE6F
the address of pb = 00000000005FFE68
避免访问未初始化的指针
#include <stdio.h>
int main()
{
	int *a; //指针变量*a指向哪,并不知道,随机分配
	*a = 123; // 往随机的地址赋值,会覆盖到系统.操作危险

	return 0;
}
接受用户输入,用指针修改变量
int main()
{
    int a;
    int *p = &a; // 定义一个指针变量p,存储变量a的地址
    printf("请输入一个整数:");
    scanf("%d", &a); // `%d`读取整数,`&a`传入变量a的地址
    printf("您输入的整数是:%d\n", a);

    printf("请重新输入一个整数:");

    scanf("%d", p); // p 本身就是一个指向 a 的指针,p 的值就是 a 的地址
    // scanf()不能传入`*p`,因为这样就传入数据了!

    printf("您输入的整数是:%d\n", a);
}
指针和数组
不过数组却不受限制,我们在函数中修改数组的值,是直接可以生效的:
#include <stdio.h>

void test(int arr[]);

int main() {
    int arr[] = {4, 3, 8, 2, 1, 7, 5, 6, 9, 0};
    test(arr);
    printf("%d", arr[0]);  //打印的是修改后的值了
}

void test(int arr[]) {
    arr[0] = 999;   //数组就可以做到这边修改,外面生效
}
数组名是数组第一个元素的地址
char arr[] = "hello";
printf("arr的地址 = %p\n", arr);
printf("arr的地址 = %p\n", &arr[0]); // 0 号元素的地址
//arr的地址 = 00000000005FFE7A
//arr的地址 = 00000000005FFE7A
#include <stdio.h>
int main()
{
char str[128];
printf("Enter a string: ");
// 字符串。这将读取连续字符,直到遇到一个空格字符(空格字符可以是空白、换行和制表符)。
// 第二个参数放入数组的地址
// str 是一个数组名,在表达式里会自动“退化”成指向数组首元素的指针,也就是 &str[0]
scanf("%s", str);
printf("You entered: %s\n", str);
return 0;
}scanf()其他类型的例子:
int a;
scanf("%d", &a);   // 必须写 &a
#include <stdio.h>
int main()
{
char charArray[] = "Hello, World!";
// %p 用来 打印指针(地址)
printf("charArray[0] -> %p\n", &charArray[0]); // %p 输出的地址,其实是虚拟地址,主要反映这是多少位系统和编译方式,而不是物理内存容量
// charArray[0]元素的内存地址:00000000005ffe42
// 0x00000000005ffe42 总共有8byte,它为16进制数,有64 bit
// 也就是有 64个地址总线,CPU的寻址能力有 64 bit,也就是64位操作系统
// 实际 'H' 在内存中占据的空间
printf("Size of char: %zu byte\n", sizeof(charArray[0])); // 1 byte
return 0;
}Transclude of Assembly-Language#^b3d2c9
知道了数组名是数组第一个元素的地址,那么以此类推,第二个元素的地址就是第一个元素的地址加上每一个元素所占的空间。比如 int 占4 byte,第一个元素的地址为0x00000000,第二个就是0x00000004
#include <stdio.h>

int main()
{
    char charArray[] = "Hello, World!";
    int intArray[] = {1, 2, 3, 4, 5};
    float floatArray[] = {1.1, 2.2, 3.3, 4.4, 5.5};
    double doubleArray[] = {1.11, 2.22, 3.33, 4.44, 5.55};

    // %p 用来 打印指针(地址)
    // charArray address: char[0]->00000038071ff9c2, char[1]-> 00000038071ff9c3, char[2]-> 00000038071ff9c4
    // char 每个占 1 byte
    printf("charArray address: char[0]->%p, char[1]-> %p, char[2]-> %p\n", &charArray[0],&charArray[1], &charArray[2]);

    // intArray address: int[0]->000000fc345ffc80, int[1]-> 000000fc345ffc84, int[2]-> 000000fc345ffc88
    // int 每个占 4 byte
    printf("intArray address: int[0]->%p, int[1]-> %p, int[2]-> %p\n", &intArray[0],&intArray[1], &intArray[2]);

    // floatArray address: float[0]->000000fc345ffc60, float[1]-> 000000fc345ffc64, float[2]-> 000000fc345ffc68
    // float 每个占 4 byte
    printf("floatArray address: float[0]->%p, float[1]-> %p, float[2]-> %p\n", &floatArray[0],&floatArray[1], &floatArray[2]);

    // doubleArray address: double[0]->000000fc345ffc30, double[1]-> 000000fc345ffc38, double[2]-> 000000fc345ffc40
    // double 每个占 8 byte
    printf("doubleArray address: double[0]->%p, double[1]-> %p, double[2]-> %p\n", &doubleArray[0],&doubleArray[1], &doubleArray[2]);

    return 0;
}
用一个指针指向数组,应该怎么做呢?
char charArray[] = "Hello, World!";
char *p;

// 第一种方法
p = charArray;
// 第二种方法
p = &charArray[0];
指针的运算
当指针指向数组元素的时候,我们可以对指针变量进行加减运算,这样做的意义相当于指向距离指针所在位置向前或向后第n个元素。
#include <stdio.h>

int main()
{
    char charArray[] = "Hello, World!";
    char *p;
    p = charArray;

    // %c 输出一个单一的字符
    printf("*p= %c, *(p+1)= %c, *(p+2)= %c \n", *p, *(p+1), *(p+2)); // *表示访问指针变量指向的数据
    // *p= H, *(p+1)= e, *(p+2)= l
    return 0;
}对比标准的下标法访问数组元素,这种使用指针进行间接访问的方法叫做指针法。
需要郑重强调的是:p+1并不是简单地将地址加1,而是指向数组的下一个元素。为什么?在定义变量char *p;的时候,编译会自动推断每个地址的间隔,比如char类型间隔为 1 byte。
char *str = "Hello";"Hello" 的类型是 const char[6](包括结尾的 '\0')
通过指针遍历字符串的内容
int i, length;
length = strlen(str);

for(i = 0; i < length; i++)
{
	printf("%c", str[i]);
}
printf("\n");
详细代码:
#include <stdio.h>
#include <string.h>

int main()
{
    char *str = "Hello";
    int i, length;
    length = strlen(str);

    for (i = 0; i < length; i++)
    {
        printf("%c", str[i]);
    }
    printf("\n"); // output: Hello
    return 0;
}
用一个指针指向数组,来求字符串数组的长度
#include <stdio.h>
int main(){
    char str[] = "hello";
    char *target = str; // 指向数组的第一个元素
    int count = 0;

    while(*target++ != '\0'){ // 遍历直到遇到字符串结束符
        printf("target = %c\n", *target); // 输出当前字符
        count++; // 移动指针到下一个字符
    }
    /*
        后缀自增,先判断 target != '\0'这个表达式,再自增
    */
   /*
    target = e
    target = l
    target = l
    target = o
    target = �,  �是字符串结束符,不是可见字符
		*/

    printf("the length of str is %d\n", count); // 输出字符串长度

return 0;注意不能直接使用数组名*str++,这个代表对字符串的地址自增。(字符串的地址不是一个左值,它是不可改变的)
需要使用lvalue来解决,在上面的例子中定义了一个指针target指向数组的元素。
C语言的术语lvalue指用于识别或定位一个存储置的标识符。(注意:左值同时还必须是可改变的)
指针数组和数组指针
int *p1[5];
// 查阅c运算符优先级可知,数组下标[]的优先级比*要高
// 所以p1先跟[5]结合
这个数组存储类型为指向整型变量的指针
| index | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| element | int* | int* | int* | int* | int* |
指针数组
创建一个指针数组,并且遍历
#include <stdio.h>

int main(){
    int a = 1;
    int b = 2;
    int c = 3;
    int d = 4;
    int e = 5;
    int *p[5] = {&a, &b, &c, &d, &e}; // 定义一个指针数组,存储5个int类型变量的地址
    int i;
    for(i = 0; i < 5; i++){
        printf("Value of a[%d] = %d\n", i, *p[i]); // 通过指针访问变量的值
    }
     /*
        Value of a[0] = 1
        Value of a[1] = 2
        Value of a[2] = 3
        Value of a[3] = 4
        Value of a[4] = 5
     */
    return 0;
}
创建一个字符串类型的指针数组
char *p[2] = {"hello", "world"};p 是一个 数组;这个数组有 2 个元素;每个元素的类型是 char *(指向字符的指针)。
数组指针
数组指针是一个指针,它指向的是一个数组。也就是指向数组的指针。
int (*p2)[5];
// 根据c运算符规则,()[]同级,所以顺序是从左往右
// 最后是*符号
graph LR p2[p2] --> array["| 下标 | 0 | 1 | 2 | 3 | 4 |<br>| 元素 | int | int | int | int | int |"]
它指向了含有n个int类型的数组。上图中n是5。
int(*p2)[5] = {1,2,3,4,5}; // !! 错误
// 对于指针,只能用 **一个地址值** 来初始化。
数组指针需要指向 一个数组的地址!
int temp[5] = {1,2,3,4,5};
int(*p2)[5] = temp; // !! 错误
数组指针需要指向 一个数组的地址!不是数组第一个元素的地址
另一个例子:
int a = 0;
int b = 1;

int *p1 = b;
int a[5] = {1, 2, 3, 4, 5};
int *p2 = a;
指针p1和p2就单纯的指向了变量,p1指向了变量b的地址,p2指向的是a数组首元素的地址,而不是指向这个数组,它与整个的数组是无关的
所以分析一下:
常规用指针遍历数组
int a[5] = {1, 2, 3, 4, 5};
int *p = a; // 这个指针p指向数组第一个元素的地址
// 不指向数组!

for(int i = 0; i < 5; i++)
{
		printf("Value of a[%d] = %d\n", i, *(p + i)); // 通过指针访问数组元素的值
}
/*
		Value of a[0] = 1
		Value of a[1] = 2
		Value of a[2] = 3
		Value of a[3] = 4
		Value of a[4] = 5
 */
现在我们用数组指针遍历
int main()
{
    // 数组指针是一个**指针**,它指向的是一个数组。
    int a[5] = {1, 2, 3, 4, 5};
    int (*p)[5] = &a; // 定义一个数组指针,指向一个包含5个int类型元素的数组
    // & 把数组当成一个整体

    for (int i = 0; i < 5; i++)
    {
        printf("Value of a[%d] = %d\n", i, (*p)[i]); // 通过数组指针访问数组元素的值
    }
    return 0;
}
或者这样遍历
printf("Value of a[%d] = %d\n", i, *(*p + i)); (*p)[i])
*p:解引用 p,得到它所指向的那个数组,也就是整个 a
(*p)[i]:访问这个数组的第 i 个元素
*(*p + i))
*p同样是数组 a,在表达式中会衰变为指向第一个元素的指针,类型变为 int *
(*p + i):即“第 i 个元素的地址”
*(*p + i):取该地址的值,也就是第 i 个元素的内容
指针和二维数组
int array[4][5];c语言中,定义二维数组是通过线性扩展的方式进行的。
上面代码,先是定义四个元素的一维数组。
array[0] | array[1] | array[2] | array[3] |
|---|---|---|---|
其中每个元素都包含一个 5个整型变量的一维数组。 | |||
| 在内存中是以线性的方式进行存储的。 | |||
array[0] → array[0][0] ~ array[0][4] | |||
array[1] → array[1][0] ~ array[1][4] | |||
array[2] → array[2][0] ~ array[2][4] | |||
array[3] → array[3][0] ~ array[3][4] |
int a[4][5];
int (*p)[5] = a;  // ✅ 正确:a 是指向含 5 个 int 的数组的指针
如果我们定义:
int (*p)[5] = array; // p 是一个“指向包含5个int的数组”的指针那么:
p        == array
p + 1    == array + 1  // 指向下一行
*p       == array[0]   // 第一行
*(p + 2) == array[2]   // 第三行
*(*(p + 2) + 3) == array[2][3]  // 第三行第四个元素
#include <stdio.h>
int main()
{
int array[4][5] = {0};
// 初始化 {0} 意味着把第一个元素置为 0,其他未显式初始化的元素会被自动置为 0 —— 所以整个数组都为 0。
printf("size of int: %d bytes\n", sizeof(int)); // size of int: 4 bytes
printf("array 的首地址:%p\n", array);
printf("array + 1:%p\n", array + 1);
/*
array 的首地址:000000f14bbff600
array + 1: 000000f14bbff614
*/
// 0x614 - 0x600 = 0x14 = 20 (十进制)
// 所以这个二维数组的每个元素占5个int,5 * 4 bytes = 20 bytes
return 0;
}*(array+1) == array[1]
| i\j | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| 0 | 0 | 1 | 2 | 3 | 4 |
| 1 | 5 | 6 | 7 | 8 | 9 |
| 2 | 10 | 11 | 12 | 13 | 14 |
| 3 | 15 | 16 | 17 | 18 | 19 |
| 创建一个二维数组,并填充数据 |
int array[4][5] = {0}; // 定义一个 4 行 5 列的二维数组,并初始化为 0
int i, j, k = 0;

for(i = 0; i < 4; i++) // 行 rows
{
		for(j = 0; j < 5; j++) // 列 columns
		{
				array[i][j] = k++;
		}
}| 表达式 | 含义 | 类型 |
|---|---|---|
array | 指向第 0 行的指针(即 &array[0]) | int (*)[5](指向含 5 个 int 的数组) |
array + 1 | 指向第 1 行(即 &array[1]) | int (*)[5](指向含 5 个 int 的数组) |
*(array + 1) | 取出第 1 行的数组名(退化为指向该行首元素的指针) | int * |
array[1] | 第 1 行的数组名,也退化为指向 array[1][0] 的指针 | int * |
printf("*(array+1): %p\n", *(array + 1));
printf("array[1]: %p\n", array[1]);
printf("&array[1][0]: %p\n", &array[1][0]); // 输出同样的地址
array → &array[0]
array + 1 → &array[1]
*(array + 1)
解引用一次:
*(array + 1) == array[1]
它表示第 1 行(也就是第二行)的一维数组:
array[1] == { 5, 6, 7, 8, 9 }
(因为前面的循环填充了 0~19 这 20 个数)
再看 **(array + 1)
解引用第二次:
**(array + 1) == array[1][0]
也就是第二行第一列的元素。
printf("**(array+1): %d\n", **(array + 1)); // 5*(*(array+1)+3)
*(array+1)+3代表第二行第四个元素 (因为下标从0开始)
在对他进行解引用,就是8了。
| i\j | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| 0 | 0 | 1 | 2 | 3 | 4 |
| 1 | 5 | 6 | 7 | 8 | 9 |
| 2 | 10 | 11 | 12 | 13 | 14 |
| 3 | 15 | 16 | 17 | 18 | 19 |
| 结论 | |||||
*(array+i) == array[i]并且可以推广到多维数组。 | |||||
*(*(array+i)+j) == array[i][j] |
初始化二维数组可以简写:
int array1[2][3] = {{0,1,2},{3,4,5}};

// 可以简写为
int array2[][3] = {{0,1,2},{3,4,5}};// rows可以省略
int (*p)[3]; // 定义一个数组指针
p = array; // array为二维数组第一行的子数组的指针| 0 | 1 | 2 |
|---|---|---|
| 3 | 4 | 5 |
printf("**(p): %d\n", **(p)); // 0
// 访问第二行第一列元素
printf("**(p+1): %d\n", **(p + 1)); // 3
#include <stdio.h>
int main()
{
int array[][3] = {{0,1,2},{3,4,5}};
int (*p)[3]; // 定义一个数组指针
p = array;
// 3
printf("**(p+1): %d\n", **(p + 1)); // 访问第二行第一列元素
printf("**(array+1): %d\n", **(array + 1));
printf("array[1][0]: %d\n", array[1][0]);
// 5
printf("*( *(p+1) + 2 ): %d\n", *( *(p + 1) + 2 )); // 访问第二行第三列元素
printf("*( *(array+1) + 2 ): %d\n", *( *(array + 1) + 2 ));
printf("array[1][2]: %d\n", array[1][2]);
return 0;
}void 和 NULL指针
Void指针
Void指针我们把它称之为通用指针,就是可以指向任意类型的数据。也就是说,任何类型的指针都可以赋值给Void指针。
#include <stdio.h>
int main() {
int num = 1024;
int *pNum = #
char *pStr = "Hello World!";
void *pVoid;
pVoid = pNum;
printf("pNum: %p, pVoid: %p\n", pNum, pVoid);
pVoid = pStr;
printf("pStr: %p, pVoid: %p\n", pStr, pVoid);
}pNum: 0000002E7D7FF894, pVoid: 0000002E7D7FF894
pStr: 00007FF6F6C44000, pVoid: 00007FF6F6C44000
可以看到可以把其他类型的指针赋给void类型的指针,而且指针内容不会改变(都是同一段内存空间)。
稍微改下代码调试
#include <stdio.h>
int main() {
int num = 1024;
int *pNum = # // 指针变量 pNum
char *pStr = "Hello World!";
void *pVoid; // void类型指针
pVoid = pNum;
printf("pNum: %p, pVoid: %p\n", pNum, pVoid);
//注意这里报错,不能直接对pVoid进行解引用
// 编译器无法知道 pVoid是什么类型,和它的宽度
//printf("*pNum: %d\n", *pVoid);
pVoid = pStr;
printf("pStr: %p, pVoid: %p\n", pStr, pVoid);
// 字符串就可以,c语言中,只需指向字符串变量的起始位置
// 就会自动一个一个字符读取,直到读到 '\0' 空字符截至
printf("*pStr: %s\n", pStr);
}解决办法:
// 先进行类型转换
先转换成(int *)pVoid类型的指针
再进行解引用*(int *)pVoid
printf("*pNum: %d\n", *(int *)pVoid);NULL指针
#define NULL ((void *)0)把0变为一个指针,在大部分的操作系统中,地址0通常是一个不被使用的地址。
当你还不清楚要将指针初始化为什么地址时,清将它初始化NULL;在对指针进行解引用时,先检查该指针是否为NULL。这种策略可以为你今后编写大型程序节省大量的调试时间。